Performance d’inférence : chargement, premier token, décodage et débit
Les tokens par seconde ne décrivent qu'une partie de l'inférence. Un générateur rapide peut faire attendre pendant le traitement d'un long prompt, une file ou le chargement. Avant de comparer les moteurs, préciser s'il s'agit d'un utilisateur local ou de requêtes concurrentes, et si l'on privilégie le premier résultat ou la fin du lot.
Séparer les étapes d'une requête
Un modèle non résident demande lecture des fichiers, allocation mémoire, transfert vers le matériel et parfois compilation ou préparation des noyaux. Le texte doit aussi être tokenisé. Le prefill traite les tokens d'entrée et construit l'état utile à la génération ; le décodage autorégressif ordinaire ajoute ensuite les tokens successivement. Files, réseau et tampons clients ajoutent de l'attente.
Le benchmark de service vLLM expose ces différentes latences et leurs percentiles. Tout autre outil doit préciser des frontières comparables, notamment l'inclusion de la file côté client.
Calculer à partir d'une chronologie
Supposons un envoi à 0 seconde, un premier token à 0,8 seconde, et le 101e et dernier à 2,8 secondes. Sans délai final supplémentaire, le TTFT vaut 0,8 seconde. L'intervalle moyen suivant est (2.8 - 0.8) / (101 - 1) = 0.02 seconde, soit 50 tokens/s pendant cette phase. Diviser tous les tokens par la durée entière donne environ 36,1 tokens/s. Les deux valeurs ont un sens différent.
Cette chronologie est inventée et ne représente aucun matériel mesuré. Les blocs de streaming peuvent contenir plusieurs tokens : utiliser le tokenizer du modèle ou un comptage serveur fiable, pas le nombre de blocs, et conserver la définition choisie.
Les lots changent le compromis
Regrouper les requêtes peut mieux utiliser lecture des poids et calcul, mais ajoute parfois l'attente du lot. Le traitement continu permet aux séquences terminées de sortir et à de nouvelles d'entrer sans attendre la plus longue. Le débit global peut augmenter alors que chaque utilisateur reçoit ses tokens moins fréquemment.
La concurrence augmente aussi le besoin de cache KV. PagedAttention gère ses allocations dynamiques par pages afin de réduire fragmentation et duplication. Cela traite un problème de gestion mémoire, sans supprimer les limites de poids, de capacité ou de calcul.
Les tâches à longue entrée et courte sortie mettent en évidence prefill et TTFT ; les tâches inverses exposent le décodage. Le décodage en petit lot est souvent limité par le déplacement des poids, tandis qu'un prefill plus grand exploite mieux les calculs matriciels. Le matériel et les noyaux déterminent toutefois le goulot réel. Précision réduite, lots plus grands et contexte plus court modifient des coûts différents.
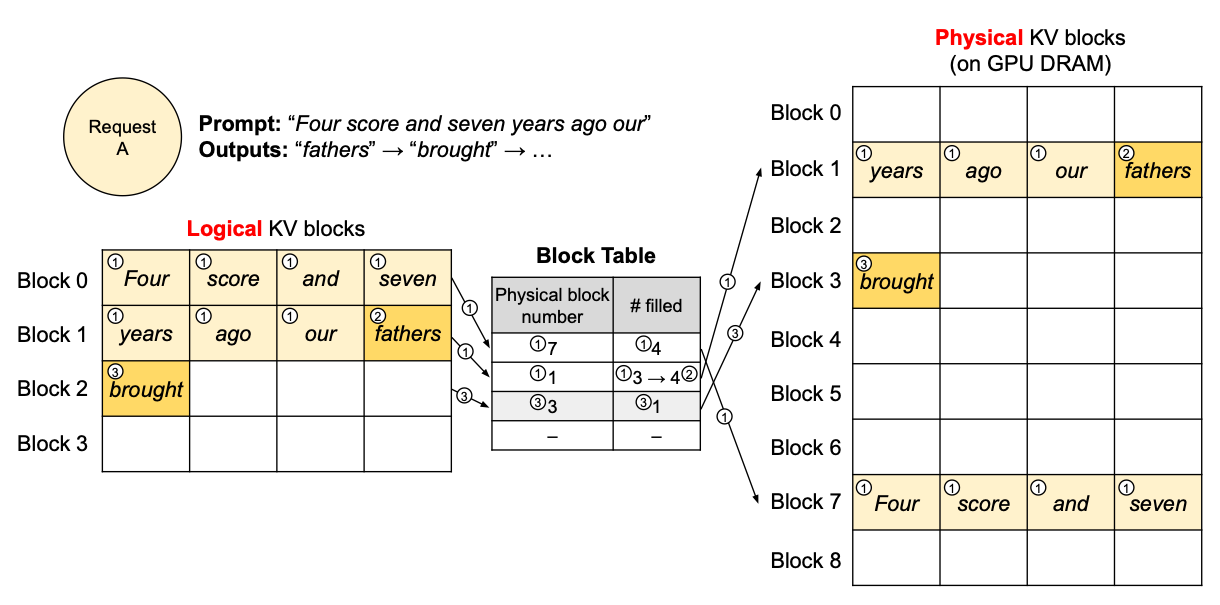 Voir l’image en grand
Suivez les blocs logiques 0, 1 et 2 vers les blocs physiques 7, 1 et 3. L’ordre des tokens reste intact malgré un stockage dispersé. Un nouveau bloc est alloué lorsque le dernier est plein. Les quatre tokens par bloc illustrent le principe : la pagination gère l’allocation sans compresser les vecteurs KV.
Distinguer les caches
Résidence du modèle, noyaux préchauffés et cache de préfixe sont trois situations différentes. Un modèle chargé n'implique pas un prompt en cache ; un texte système répété peut accélérer les requêtes suivantes. Comparer séparément démarrage à froid, modèle résident sans préfixe réutilisé, et taux de réutilisation réaliste.
La réutilisation suppose des entrées et une configuration compatibles. Répéter exactement le même prompt mesure un cas idéal, pas des tâches changeantes. Changer modèle, adaptateur ou contexte ne doit pas laisser un ancien cache considéré comme valide.
Conserver échecs et longues attentes
Fixer version, quantification, matériel, moteur, distribution des longueurs, limites de sortie et concurrence. Mélanger requêtes courtes et longues représentatives, séparer préchauffage et mesure, puis rapporter médiane et percentiles élevés avec dépassements de délai, erreurs, longueurs produites et pic mémoire. Ne conserver que les sorties courtes et réussies embellit les résultats.
Une charge croissante peut faire exploser la file. Un client qui attend chaque réponse avant d'envoyer la suivante réduit automatiquement la pression et peut masquer la surcharge. Choisir une concurrence fixe ou un taux d'arrivée fixe selon l'usage, puis le préciser. Un p99 calculé sur très peu de requêtes reste instable.
Enfin, mesurer réponses correctes, réussite des outils et reprises nécessaires. Un débit élevé ne compense pas le temps consacré à un mauvais travail. Le choix du moteur traite la compatibilité ; l'évaluation des modèles et agents locaux traite les résultats des tâches.