Agent 上下文工程
上下文工程要解决的是:Agent 做下一步时,需要看到哪些指令、文件和近期结果。长期记录仍需单独保存,不能只依赖提示词。上下文窗口限制了模型一次能接收多少信息,却不保证这些信息都能被有效利用。《Lost in the Middle》发现,信息在长输入中的位置可能影响检索质量。因此,应优先提供与当前行动相关、仍然有效的证据,而不是把窗口填满。
本页关注一次任务的工作集:模型现在必须看到什么,哪些材料可以留在窗口之外。怎样找到候选材料见检索流程:切分、召回、重排与引用,怎样跨任务保存和更新信息见Agent 记忆:保存、更新与失效。
 查看清晰大图
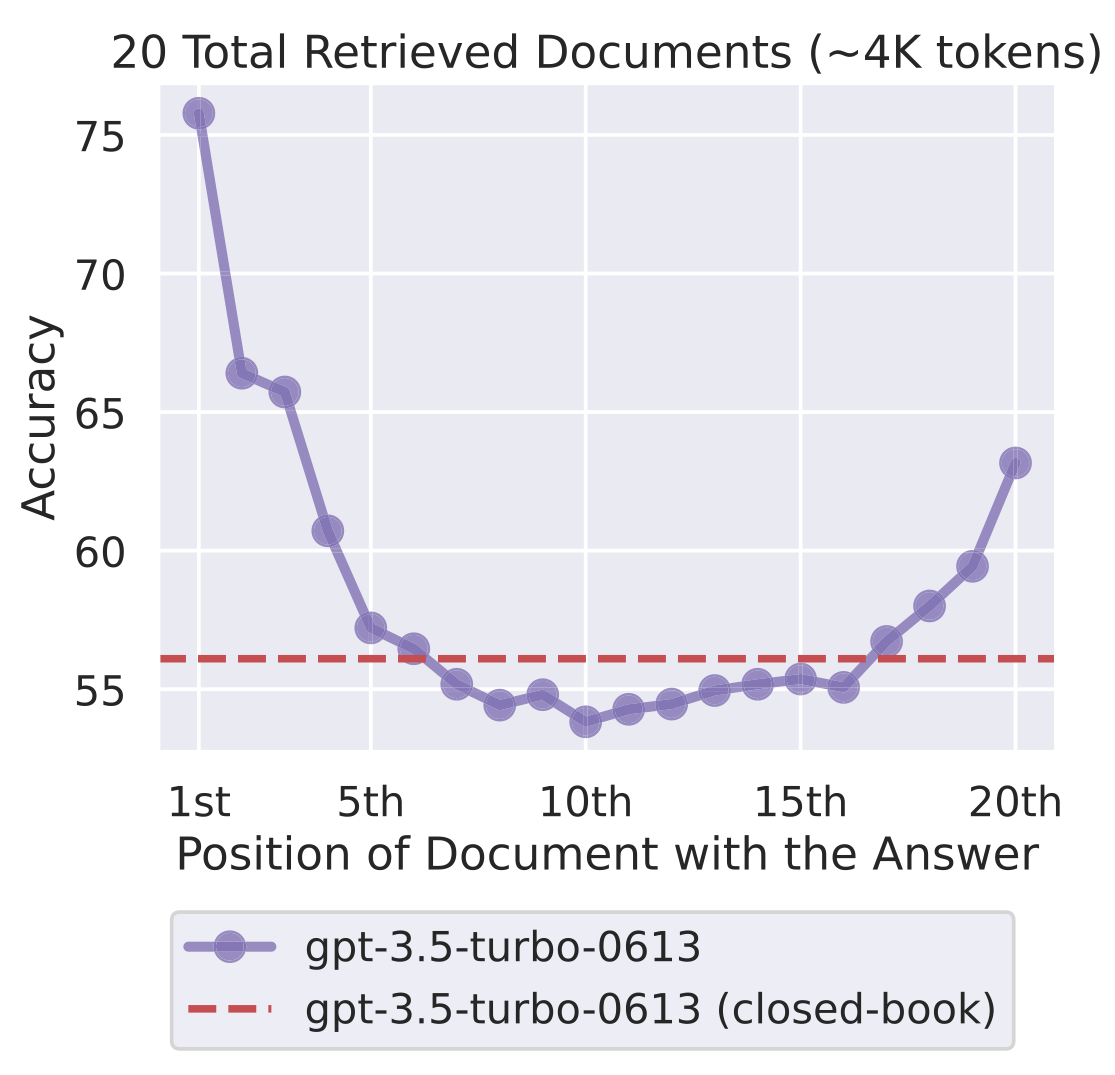
沿横轴看:总共 20 篇文档、约 4,000 个 Token,变化的是含答案段落的位置。纵轴是问答准确率,不是检索器的召回率。在这次 GPT-3.5-Turbo-0613 实验中,答案放在中间时的表现低于两端;虚线是不提供文档的闭卷基线。可以据此测试所用模型对证据位置是否敏感,但不能把这条历史曲线当作所有模型的成绩。
任务包示例
任务包是交给 Agent 的一份精简说明:这一步能改什么、怎样算成功、试过什么、看哪些代码、还有什么没决定。针对一个在处理分割 UTF-8 序列时失败的解析器,一个有效的任务包可能如下所示:
contract:
  write_scope: [src/parser.py, tests/test_parser.py]
  success: targeted test and parser suite pass
state:
  attempted: boundary check after byte slicing
  result: still fails on a split multibyte code point
working_set:
  - parser function and two callers
  - three relevant tests
  - exact traceback
open_question: should truncation operate on bytes or Unicode code points?
包含整个仓库、完整的测试日志和所有早期假设虽然内容更多,但并不一定更有帮助。
上下文中该放什么
上下文里的材料分五层。它们不是先后步骤,而是同时存在、稳定程度不同的五类东西:
前四层可以进入 Prompt。持久状态留在外部,仅在需要时按需加载。对话记录(Transcript)只是交互历史,不应作为项目的唯一事实来源(System of Record)。
先检索,再压缩
在让模型总结之前,先通过符号、调用点、测试用例和定义搜索确凿的证据。总结无法恢复从未被检索到的材料,而反复总结容易将猜测悄悄固化为事实。
能放进去的输入,等于模型上限减去留给输出的部分、工具定义和 schema 占掉的部分,再减去一点安全余量:
代入一组数:窗口 128K Token,留 8K 给输出,工具定义占 6K,再留 4K 余量,128K − 8K − 6K − 4K = 110K,能放进去的输入约 110K Token。
规则、证据和输出之间没有通用的比例分配。下一步行动应决定任务包的内容。本地模型还要算上 KV 缓存:模型为已经读过的每个 Token 保留的中间结果,随上下文变长占用越来越多的内存。所以本地模型可能在达到宣传的上下文极限之前,就先触碰到 KV 缓存或内存限制。
保持工作集精简的方法
提示词缓存在指令和模式真正稳定不变时效果最佳。实际节省取决于提供商、模型、请求形状和缓存策略,应通过实测数据评估,而非直接套用宣传的百分比。
大型输出应完整存储;放进上下文时,只带上有用片段和原始文件位置。首尾截断只是一种选项,不能保证重要行一定被保留。
压缩时不掩盖不确定性
总结时应保留:
- 主张背后的来源或原始文件;
- 陈述是观察所得、推断得出还是仅提出假设;
- 失败的尝试,以避免重复错误;
- 未解决的矛盾;
- 下一个决策点,而非每一轮对话细节。
结构化状态通常比散文式回顾更易于检查,但这并不意味着它自动正确。尽可能原子化地更新状态,并在恢复时与当前文件进行核对。
如何测试上下文策略
将相同的证据分别放置在开头、中间和结尾进行测试。添加无关和冲突的文档。包含一个正确答案为“证据不足”的案例。测量任务成功率、遗漏的约束、归因准确性、延迟和 Token 使用情况。
测试中常见的失败有五种,放在 UTF-8 解析器的例子里是这样的:
解决办法通常是移除无关材料、检索更好的证据,或将持久状态移出提示词。