Architecture de Jupyter
Une session locale de notebook implique généralement trois rôles plutôt qu’un unique « processus de notebook » :
- Client : l’interface du navigateur ou de l’éditeur où les cellules sont modifiées et les sorties affichées.
- Serveur : gère les fichiers, sessions, l’authentification, les connexions HTTP/WebSocket et le cycle de vie des noyaux.
- Noyau : un processus propre à un langage qui exécute le code et conserve l’état d’exécution.
Ces rôles peuvent s’exécuter sur une même machine ou être répartis entre des machines reliées à distance. D’autres interfaces peuvent aussi parler le protocole de messagerie Jupyter sans utiliser l’interface classique Notebook.
Ce que contient le fichier notebook
Un fichier .ipynb est du JSON contenant :
- des cellules Markdown et de code ;
- les métadonnées des cellules et du notebook ;
- des sorties enregistrées telles que du texte, des images et des données d’affichage enrichies ;
- des indications sur le noyau et le langage.
Il ne contient pas le processus Python ou R actif, les paquets installés, les jeux de données externes, les variables d’environnement ni tout l’état caché ayant influencé l’exécution. Un notebook enregistré peut donc s’afficher correctement sur la machine d’origine, puis échouer lorsqu’on le réexécute ailleurs : l’état de l’environnement ne voyage pas avec le fichier.
Flux entre client, serveur et noyau
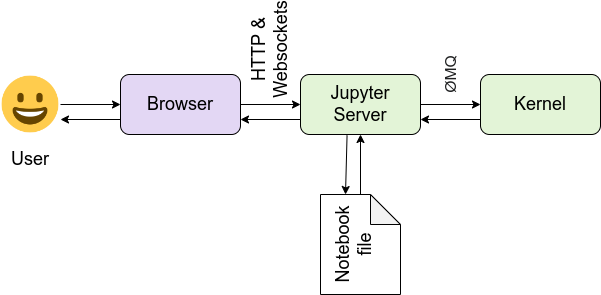
Lorsqu’une session a besoin d’un noyau, le serveur en démarre un ou se connecte à un noyau existant et conserve ses paramètres de connexion ZeroMQ.
- Le client dans le navigateur communique normalement avec le serveur par HTTP et WebSocket.
- Le serveur fait le lien en relayant les messages vers les canaux Jupyter du noyau.
- Le noyau conserve les variables entre les cellules jusqu’à son redémarrage ou son arrêt. Son processus et son espace d’adressage portent cet état ; ce noyau de langage est distinct du noyau du système d’exploitation.
Ouvrir un notebook démarre souvent son noyau sélectionné ou s’y connecte, mais le comportement exact dépend de l’interface et de l’état de la session. Consulter un notebook statique ne nécessite pas de noyau actif.
 Voir l’image en grand
Suivez les deux chemins qui partent du serveur : l’un transmet le code au noyau, l’autre lit et écrit le fichier notebook. Enregistrer le notebook sauvegarde donc un document, pas le processus actif du noyau. Le navigateur utilise HTTP et WebSocket ; le serveur communique avec le noyau par ZeroMQ.
Conversion avec nbconvert
Le traitement par nbconvert suit ces étapes :
- Lire le document du notebook.
- Appliquer les préprocesseurs facultatifs.
- Transmettre le résultat à un exportateur, par exemple HTML ou Markdown.
- Pour certains formats, appliquer des modèles ou des postprocesseurs.
Par défaut, la conversion n’exécute pas le code ; un export ordinaire peut reprendre les sorties déjà enregistrées dans le fichier. Le notebook n’est réexécuté que si l’exécution est explicitement configurée.
jupyter nbconvert --to html analysis.ipynb
Conséquence pratique
Le compteur d’exécution d’un notebook et ses sorties visibles ne garantissent pas sa reproductibilité.
Pour rendre l’exécution reproductible :
- Redémarrer le noyau.
- Exécuter toutes les cellules dans l’ordre.
- Figer les dépendances de l’environnement, par exemple avec
requirements.txtouenvironment.yml. - Consigner toutes les données d’entrée externes.
Déplacer le code réutilisable et le code de production dans des modules indépendants munis de tests, en particulier lorsqu’il est critique pour la production. Le notebook sert alors à appeler ces modules plutôt qu’à porter la logique de l’application.